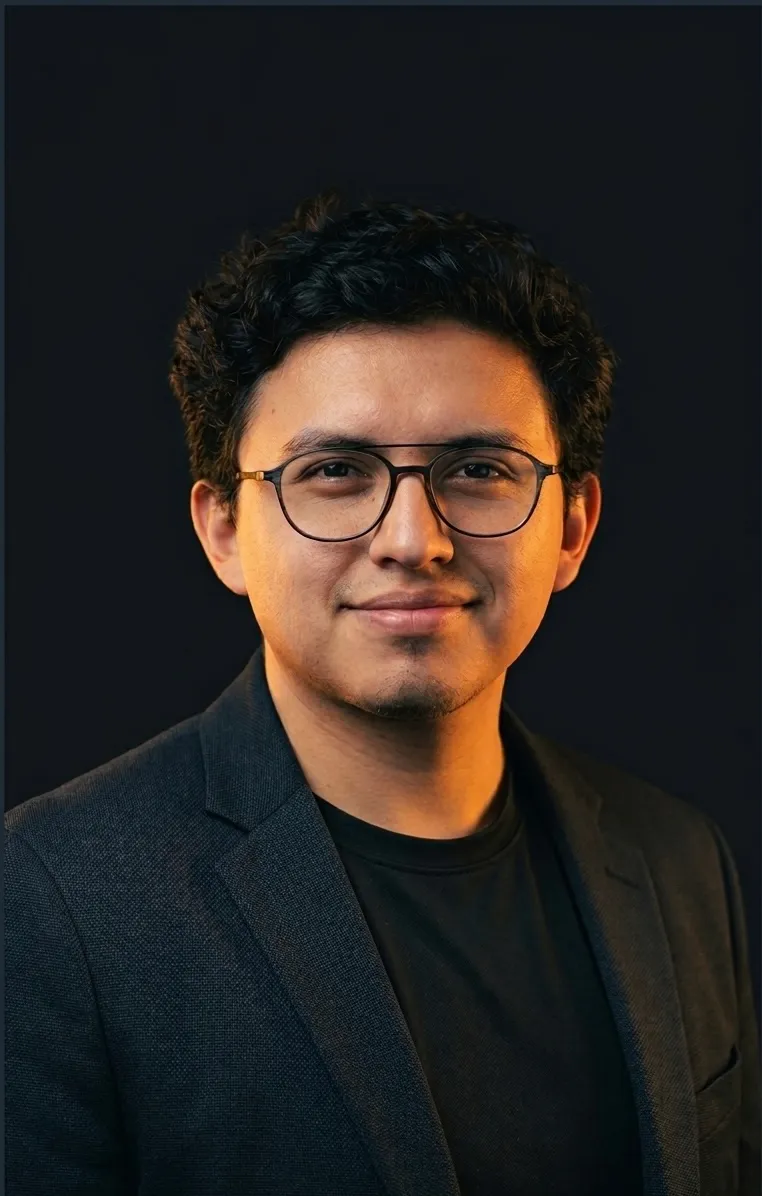
Retrato de Eduardo Rodríguez Ávila
disponible para trabajar

Físico · AI Developer · Data Scientist/ML

Eduardo Rodríguez Ávila

Los modelos compiten en benchmarks.

Los productos compiten en producción.

Ver CV
planificación por asignatura en ILC-HUB (antes 2–3 semanas)
30–40 min
AUC-ROC en Fraud Detection (baseline 0.844)
0.899
ILC-HUB v3, en producción con usuarios reales
02/2026

Construyo infraestructura para operar modelos: harness engineering. Cada resultado trazable. Cada costo auditado. La responsabilidad, humana.

// Ciudad de México

últimos proyectos

ver todos →

01 / Sobre mí

Lo vivido gana a lo diseñado.

El discurso dominante de IA en 2026 sigue centrado en el modelo: qué tan grande, qué tan bien evaluado, qué tan rápido. Pero los productos de IA que entregan valor real comparten algo que no aparece en los benchmarks: detrás hay alguien que conoce el problema porque lo vivió, no porque lo investigó.

Esa convicción organiza mi trabajo. Vengo de la física, ocho años de aula y de construir y operar una plataforma diseñada en torno a la IA (AI-native), en producción. Los tres me dicen lo mismo: la ventaja sostenible está en la distancia entre quien diseña la solución y quien sufrió el problema. A menor distancia, mejor producto.

Lo que esto significa en concreto:

  • Un modelo debe operar para ser producto.

    Reglas al operar, no en un documento: gobernanza en registros, colas, instrucciones (prompt) con versión y quién firma cada resultado.

  • La mayoría de lo que llamamos “problemas educativos” es burocracia que le roba tiempo a la gente para hacer su trabajo.

    Lo aprendí en aula; lo confirmé construyendo ILC. El sistema funciona porque resuelve un problema que yo viví, no uno que imaginé.

  • El harness es humano.

    Los avances reales aparecen al sostener razonamientos largos durante horas. Ese trabajo es humano. La responsabilidad por lo que genera el sistema no se delega al algoritmo.

Me interesan equipos que construyan productos reales en DS/ML con IA en producción — con la responsabilidad anclada en una persona, no en el algoritmo.

02 / Cómo trabajo

Cuatro capas de la práctica. Cuatro categorías de responsabilidad.

// proyectos:

// elige un nodo para leer qué es, o un proyecto para encender sus capas.

Cuatro capas de responsabilidad al construir con IA: 1. Experiencia: Inmersión, Usuarios, Restricciones, Métricas reales. 2. Sistema (harness): Contexto, Control, Orquestación, Validación. 3. Operación (runtime): Observabilidad, Costos, Trazabilidad, Resiliencia. 4. Custodia: Persona, Disyuntivas, Auditoría, Incidentes.

Saltar la red
ExperienciaEl contexto del problemaInmersiónUsuariosRestriccionesMétricas reales
SistemaHarness: lo que opera al modeloContextoControlOrquestaciónValidación
OperaciónRuntime: el sistema en producciónObservabilidadCostosTrazabilidadResiliencia
CustodiaUna persona responde por el resultadoPersonaDisyuntivasAuditoríaIncidentes
// El AI Index 2026 clasifica por principio. Esta red, por lugar en el sistema.

Experiencia — Inmersión

Estar adentro del problema antes de modelar. La diferencia entre quien lo vivió y quien lo investigó.

Experiencia — Usuarios

Personas concretas con tareas concretas. La métrica que cuenta es lo que cambia en su día.

Experiencia — Restricciones

Las reales, no las cómodas. Tiempo, regulación, costo, fricción institucional.

Experiencia — Métricas reales

El resultado real pesa más que la exactitud del modelo. Éxito en el mundo, no en el artículo.

Sistema — Contexto

Lo que el modelo necesita saber para responder bien. Recuperación, memoria, embeddings.

Sistema — Control

La superficie de invocación del modelo. Prompts versionados, herencia, snapshots.

Sistema — Orquestación

Cómo se coordinan las llamadas. Colas, prioridades, dependencias.

Sistema — Validación

El humano en el ciclo. Qué se conserva, qué se tira, qué se itera.

Operación — Observabilidad

Qué ve el operador. Logs, trazas, dashboards.

Operación — Costos

Lo que cuesta cada resultado. Auditado por API, optimizado mientras el sistema opera.

Operación — Trazabilidad

De cada resultado a su origen: instrucciones (prompt), contexto y versión.

Operación — Resiliencia

Qué pasa cuando algo falla. Fallback, degradación segura, recuperación.

Custodia — Persona

Quien se hace cargo del resultado. No el algoritmo ni el proveedor.

Custodia — Disyuntivas

Qué se cede y qué se gana. Costo, tiempo de respuesta (latencia), riesgo: responde la persona, no el modelo.

Custodia — Auditoría

Lo que se registra para revisión. Un registro de auditoría accesible.

Custodia — Incidentes

Qué pasa cuando el resultado hace daño. Quién responde, cómo se corrige, qué se aprende.

03 / Proyectos

Harness Engineering · Agentic-Native · EdTech

repo privado · IP protegida

ILC-HUB

Integrated Learning Core

Un wrapper resuelve la API. Un harness resuelve el problema. ILC-HUB es una plataforma para EdTech diseñada en torno a la IA (AI-native), construida desde un problema vivido ocho años en aula: la planificación didáctica que toma dos a tres semanas por asignatura y termina con cuatro profesores enseñando el mismo concepto de cuatro formas distintas, sin sistema compartido. El harness reduce ese trabajo a treinta o cuarenta minutos y devuelve coherencia global a la planeación. En operación con usuarios reales desde principios de 2026, con la responsabilidad por cada resultado anclada en una persona, no en el algoritmo.

Versiones

  1. 09/2024

    v1

    El germen: primeras pruebas de generación asistida, aún en prototipo

  2. 01/2026

    v2

    Primer núcleo del harness: de prototipo a sistema con interfaz propia

  3. 02/2026

    v3

    En producción y a escala: multi-asignatura, cada resultado trazable; precursor de lo agéntico

  4. en curso

    v4

    Siguiente salto: arquitectura agent-native, con los agentes en su núcleo

766

planes de clase generados

117

endpoints de API

51

releases con versionado semántico

2+ años

construyendo la plataforma

  • Python
  • FastAPI
  • OpenAI API
  • MongoDB
  • React
  • TypeScript
  • Docker
  • Railway

Machine Learning · MLOps · Fintech

repo público

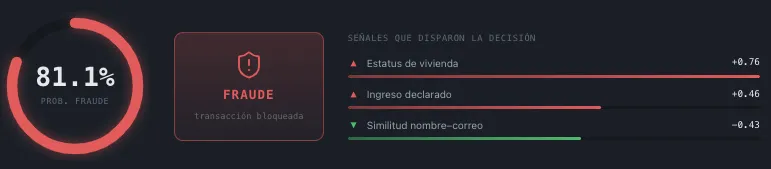
Fraud Detection scoring de fraude en tiempo real

Decir que se sabe es CV. Mostrar el código es evidencia. Fraud Detection es un sistema de scoring de fraude bancario en tiempo real, construido como proyecto público para demostrar el ciclo end-to-end fuera de EdTech. Entrenado sobre un dataset académico de referencia: un millón de transacciones reales con la dificultad que la literatura reconoce como más exigente — un desbalance de noventa a uno entre transacciones legítimas y fraudulentas. Cada predicción acompañada de su explicación; servido en producción, con repositorio abierto.

  • Python
  • FastAPI
  • Docker
  • Railway
  • XGBoost
  • Astro

Data Science · EDA · Education

repo en preparación

MIT GTL ChiMIT · Sleep Clinic

Colaboración con el MIT Global Teaching Labs: co-diseño y liderazgo del Code Development Work Cell. EDA sobre ~180k registros de sueño con 25 estudiantes, guiado con notebooks parametrizados que explican el código línea a línea.

  • Python
  • pandas
  • Jupyter
  • matplotlib

04 / Contacto

¿Buscas a alguien que construya productos de IA de extremo a extremo? Escríbeme.

Ciudad de México